扩散模型怎么把噪声一步步变成你的插画
不需要懂数学,只要建立一幅画面:AI 从一团纯噪声开始,在文本提示的引导下,每一步去掉一点噪声、补上一点结构,直到噪声归零、图像成形。
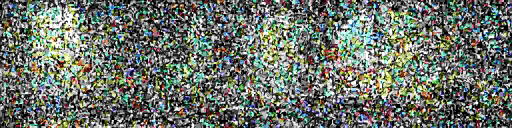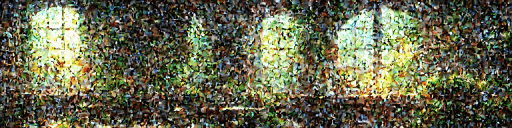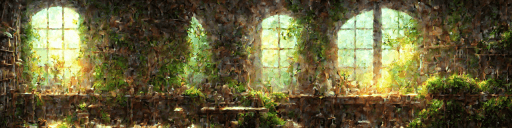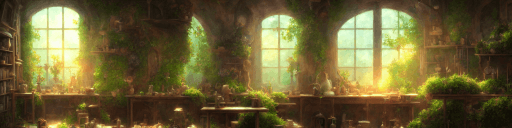
三个关键推论
- 提示词是「引导」不是「指令」:模型把你写的标签当作去噪方向的权重,而不是逐条执行的清单。同一段提示词每次生成的构图都不同,因为起点噪声是随机的。
- 种子(Seed)锁住起点:固定种子 + 相同参数 + 相同提示词,就能近乎复现上一张图——这是排障和精修的基础操作。
- 步数(Steps)是去噪轮数:轮数太少去不干净,图会糊;轮数太多边际收益递减,白烧算力。默认 23 步是官方调好的平衡点。
和 Stable Diffusion 的关系
- V3 时代基于 SDXL 架构改造;从 V4 起是完全自研的架构,不再有公开底模血统。
- 因此:同一提示词 + 同一种子,在 NovelAI 和原版 Stable Diffusion 上不会出同样的图——官方文档特别强调过这一点。
- 官方对「AI 拼贴搬运画师作品」的质疑专门发博文解释过扩散模型的学习方式,相关讨论本站不展开。
对日常使用的意义
- 出图不对味时,先怀疑提示词的引导权重(换词、调顺序、加权重语法),再怀疑参数。
- 想要「同一构图只换细节」,走图生图或固定种子微调,别裸生成碰运气。
原理细节官方博客写得最全;本站后续所有功能页都默认你已经理解「提示词=引导方向」这个设定。